LLM

事前学習Ⅱ

LLM【事前学習Ⅱ:基礎理論 A-1】

TransformerがなぜLLMの基盤なのか。Embedding・Attention・FFN・Add & Normという構成要素の役割と配置の理由を、全体像から理解します。
事前学習Ⅰ

LLM 事前学習:Transformer シリーズ総集編 vol.1

このページでわかることこのページは、大規模言語モデルの「事前学習:Transformer」シリーズ全体の案内ページです。ブログ A 〜 E を 1 ページにまとめ、一目で把握できるように整理しています。何を知りたいときにどのシリーズを見れば...
機械学習

【VLM】LLaVA-1.5 論文解説&VLM完全ガイド|基礎から本番運用まで

はじめにVision Language Model(VLM)の歴史において、一つの分岐点とも言える論文が存在します。2023年版の 「Improved Baselines with Visual Instruction Tuning (LL...
画像生成

PyTorch + Diffusersでアニメキャラクター生成に挑戦!(中編)

実装の詳細解説とGitHub公開完全ガイド。技術的な課題の解決策、パフォーマンス測定結果、本番化のアーキテクチャを詳しく解説。
基礎理論

LLM【Transformer:基礎理論A-6】

基礎用語集と確認問題:Transformerの理解度チェックこれまでの【Transformer:基礎理論 A-1〜A-5】で学んだ内容は、理解したつもりでも、用語が混ざるとすぐに曖昧になりやすいです。そこでこの記事では、重要用語を一覧で整理...
基礎理論

LLM【Transformer:基礎理論A-5】

因果的Attentionマスクと自己回帰型生成:GPTの生成原理前回は、FFN と活性化関数の役割を学びました。今回は、GPT 型モデルがどの順番で単語を生成しているのかを確認しながら、その制約を支える自己回帰型生成とCausal Atte...
基礎理論

LLM【Transformer:基礎理論A-4】

FFNと活性化関数:Transformerの知識を蓄える場所前回は、Multi-Head Attention の詳細なメカニズムを学びました。今回は、そこで拾った文脈情報をどう扱うのかという視点から、Transformer のもう1つの重要...
基礎理論

LLM【Transformer:基礎理論A-3】

Multi-Head Attentionの詳細メカニズム:文脈理解の核心前回は、Transformerの全体構造を学びました。今回は、その心臓部であるAttentionメカニズムを詳しく解説します。ここで押さえたいのは、Attentionが...
基礎理論

LLM【Transformer:基礎理論A-1】

言語モデルの本質と進化軌跡:N-gramからTransformerへスマートフォンのキーボードで「私は学校へ」と入力した時、次に出現しそうな単語を予測する機能が働きます。この「次に来そうな単語を予測する能力」こそが、言語モデル(Langua...
LLM

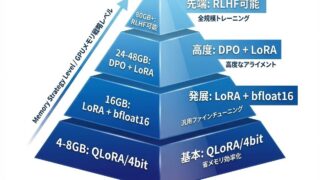
[LLM] 微調整の全手法を整理し、実務での最適解を一気に理解するためのガイド

この記事のゴール本記事では、以下の“判断軸”を最短時間で獲得します。RLHF と DPO のどちらを使うべきか、一発で決められるLoRA を中心とした PEFT の選び方が分かるGPU メモリの制約下で最適な戦略が立てられるbfloat16...