A-6:構成要素の統合と設計
A-5では、Transformerがトークン列の順序や距離を扱うために、位置情報をどのように与えるかを見ました。ここまでで、入力を作るトークン化、文脈を集めるSelf-Attention、表現を変換するFFN、学習を支える正規化、順序を伝える位置表現という主要部品がそろいました。
ただし、部品を個別に理解しただけでは、モデルを設計したことにはなりません。Attentionの前に正規化を置くのか? FFNの中間次元をどこまで広げるのか? 層数、隠れ次元、ヘッド数は、性能と計算資源の間でどのように折り合いをつけるのか? こうした選択が重なって、実際のTransformerの性格が決まります。
今回は、Decoder-only LLMを主な対象に、各部品を一つのTransformerブロックとして統合する考え方を整理します。目的は、流行している構成を暗記することではありません。「どの制約に対して、どの設計を選んだのか?」を説明し、小さな実験で確かめられるようになることです。
- 1. Transformerブロックはどの順序で情報を処理するのか?
- 2. Pre-NormとPost-Normはどのように選ぶのか?
- 3. Attentionの設計では何を決めるのか?
- 4. FFNの中間次元と活性化関数はどう決めるのか?
- 5. 層数・隠れ次元・ヘッド数の関係をどう考えるのか?
- 6. 位置表現とコンテキスト長はなぜ別々に考えるべきなのか?
- 7. 目的別に、どのような基準構成から始めるのか?
- 8. 設計を検証するとき、何を記録すべきか?
- 9. よくある失敗と、設計を戻すための手順
- 10. まとめ:部品の選択を、設計判断へ変える
- 11. 今回のブログの考察:A-7への橋渡し
- 参考文献
- このシリーズの案内
1. Transformerブロックはどの順序で情報を処理するのか?
Decoder-only Transformerでは、トークンIDをEmbeddingへ変換し、複数のTransformerブロックを通し、次トークンの確率へ変換します。各ブロックの中心にあるのは、トークン間の情報を混ぜるAttentionと、各トークンを個別に変換するFFNです。
現在広く使われるPre-Norm型の概念的な流れは、次の式で表せます。
$$ h’ = h + \operatorname{Attention}(\operatorname{Norm}(h)) $$
$$ h_{\mathrm{next}} = h’ + \operatorname{FFN}(\operatorname{Norm}(h’)) $$
ここで$h$は各トークンの隠れ表現です。残差接続によって元の$h$を保ちながら、AttentionとFFNが作った更新分を少しずつ重ねます。位置情報は、絶対位置Embeddingであれば入力Embeddingに加え、RoPEであればAttention内部のQ・Kへ適用します。
| 処理 | 主な役割 | 設計時に見る点 |
|---|---|---|
| Token Embedding | トークンIDを連続ベクトルへ変換する | 語彙サイズ、隠れ次元、入出力重みの共有 |
| 位置表現 | 順序・距離を利用可能にする | 絶対位置、RoPE、相対位置バイアス、想定文脈長 |
| Attention | トークン間で文脈を集める | ヘッド数、Q/K/Vヘッド数、系列長 |
| FFN | 各トークンの特徴を非線形に変換する | 中間次元、活性化関数、パラメータ量 |
| Normと残差接続 | 深い層での最適化を支える | Pre-NormかPost-Normか、LayerNormかRMSNormか |
重要なのは、各部品が独立して性能を決めるわけではない点です。たとえばRoPEを選んでも、長い文脈を実用的に扱えるかはAttentionのメモリ使用量、訓練時の系列長、評価タスクにも左右されます。構成は部品表ではなく、相互に影響する設計の組み合わせです。
2. Pre-NormとPost-Normはどのように選ぶのか?
A-3で見たように、Post-Normはサブレイヤーと残差接続の後に正規化を置きます。一方、Pre-Normはサブレイヤーへ入る前に正規化を置きます。
| 配置 | 概念式 | 特徴 |
|---|---|---|
| Post-Norm | $h_{\mathrm{next}} = \operatorname{Norm}(h + \operatorname{Sublayer}(h))$ | 原論文のTransformerで使われた標準形 |
| Pre-Norm | $h_{\mathrm{next}} = h + \operatorname{Sublayer}(\operatorname{Norm}(h))$ | 残差経路がより直接的になり、深いモデルで最適化しやすいことが多い |
新規にDecoder-only LLMを設計する場合、Pre-Normは再現性を取りやすい出発点です。残差経路に正規化後の変換だけを加えるため、層を重ねたときにも情報と勾配が通る経路を保ちやすいからです。LLaMAのような近年のDecoder-onlyモデルでも、この系統の構成が採用されています。
とはいえ、Pre-Normに変えれば発散が必ず解消するわけではありません。学習率、ウォームアップ、初期化、データ品質、混合精度、バッチサイズも学習の安定性に影響します。既存のPost-Normモデルを継続学習する場合は、正規化の位置を変えるだけで内部表現の分布が変わるため、単純な差し替えは避けるべきです。
3. Attentionの設計では何を決めるのか?
Attentionを設計するときにまず決めるのは、
隠れ次元 $d_{\mathrm{model}}$、
Queryヘッド数 $n_{\mathrm{heads}}$、
そして1ヘッドあたりの次元$d_{\mathrm{head}}$です。通常は、次の関係を満たすように決めます。
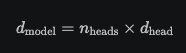
ヘッドを増やすと、異なる関係に注目する複数の視点を持たせやすくなります。しかし、ヘッド数だけを増やせば性能が上がるわけではありません。$d_{\mathrm{model}}$を固定したままヘッド数を増やすと、1ヘッドあたりの次元は小さくなります。逆に、1ヘッドの次元を保ってヘッド数を増やせば、モデル全体の幅と計算量が増えます。
生成時には、過去トークンのKeyとValueをKVキャッシュとして保持します。標準的なMulti-Head Attentionでは、キャッシュ量は概ね系列長、層数、KVヘッド数、ヘッド次元に比例します。長い文脈や多数同時生成が必要な場合、推論時の制約はパラメータ数よりKVキャッシュになることがあります。
| 方式 | QヘッドとKVヘッドの関係 | 主な特徴 |
|---|---|---|
| MHA | Q・K・Vで同数のヘッドを持つ | 標準的な構成。表現力の基準にしやすい |
| MQA | 多数のQヘッドで少数、しばしば1個のKVヘッドを共有する | KVキャッシュを大きく削減できるが、品質への影響は要検証 |
| GQA | Qヘッドを複数グループに分け、各グループでKVヘッドを共有する | MHAとMQAの中間で、推論効率と品質の折り合いを取りやすい |
MHA、MQA、GQAの選択は、「最新の方式か?」ではなく、目標とする同時実行数、コンテキスト長、推論メモリで決めるべきです。小規模な学習実験ではまずMHAを基準にし、長文生成やサービングが明確な要件になった段階でGQAなどを比較すると、原因を切り分けやすくなります。
4. FFNの中間次元と活性化関数はどう決めるのか?
Attentionがトークン間で情報をやり取りするのに対し、FFNは各トークン位置で同じ変換を適用します。標準的なGELU FFNは、隠れ次元を一度\(d{\mathrm{ff}}\)まで広げてから\(d{\mathrm{model}}\)へ戻します。
\(\operatorname{FFN}(x) = W_2\operatorname{GELU}(W_1x)\)古典的なTransformerでは\(d{\mathrm{ff}} = 4d{\mathrm{model}}\)がよく使われます。これは便利な基準ですが、普遍的な最適値ではありません。FFNはモデル全体のパラメータと計算量の大きな割合を占めるため、中間次元を広げると表現力を増やせる一方、学習・推論コストも増えます。
SwiGLUを使うFFNでは、ゲート用を含む複数の射影が必要になります。同程度のパラメータ予算でGELU型と比較したい場合、単純に\(4d{\mathrm{model}}\)へ広げるのではなく、中間次元をおよそ\(8d{\mathrm{model}}/3\)に調整する設計がよく用いられます。ただし、丸め方やバイアスの有無によって実際のパラメータ数は変わります。
5. 層数・隠れ次元・ヘッド数の関係をどう考えるのか?
モデルを大きくする方法には、主に深さを増やす、幅を増やす、FFNを広げるという選択があります。これらは同じ「パラメータ増加」でも、メモリ使用量や最適化の難しさに異なる影響を与えます。
| 変更 | 主に増えるもの | 得られやすい効果 | 代表的な注意点 |
|---|---|---|---|
| 層数を増やす | 深さ、逐次計算、活性化メモリ | 段階的な表現変換を増やす | 学習の安定性と通信回数に注意する |
| 隠れ次元を増やす | Attention・FFNの幅、パラメータ数 | 各トークンの表現容量を増やす | 行列演算とメモリ使用量が大きくなる |
| ヘッド数を増やす | Attentionの分割数 | 複数の関係を扱う設計を取りやすい | ヘッド次元との整合を確認する |
| FFN中間次元を増やす | FFNのパラメータと計算 | トークンごとの非線形変換を厚くする | 予算の大半をFFNが消費しやすい |
ここでありがちな失敗は、公開モデルの設定値を一部だけコピーすることです。たとえば、層数だけを増やしながら学習率、ウォームアップ、バッチサイズ、学習トークン数を小規模モデルのままにすると、構造変更の効果と学習設定の不足を区別できません。
最初の設計では、既存の再現可能な小規模構成を基準点にします。そのうえで、「同じパラメータ予算で深さと幅を変える」「同じ推論メモリでMHAとGQAを比べる」のように、変える要素を一つに絞ります。スケーリングの結論は、単発の学習曲線ではなく、複数規模での一貫した比較から読む必要があります。
6. 位置表現とコンテキスト長はなぜ別々に考えるべきなのか?
A-5で扱ったRoPEやALiBiは、モデルが順序と距離を利用するための設計です。一方、コンテキスト長は、学習時・推論時に何トークンを処理するかという運用上の制約です。この二つは密接ですが、同じ問題ではありません。
たとえばRoPEを使うモデルで最大長を伸ばす場合、少なくとも次の問いを分けて確認します。
- その位置表現は、目的の長さで適切に動作するよう訓練・追加学習されているか
- AttentionとKVキャッシュは、目標の系列長と同時実行数でメモリに収まるか
- 文脈の端だけでなく、中央や遠い位置の情報を実際に利用できるか
最大コンテキスト長だけを仕様に書くと、実用上の性能を見誤りやすくなります。必要な情報が長文のどこに置かれても取り出せるか、入力長の増加でレイテンシがどう変わるか、短い入力の品質を犠牲にしていないかまで評価して、初めて長文対応の設計を判断できます。
7. 目的別に、どのような基準構成から始めるのか?
新規モデルの設計で、最初からすべてを最適化する必要はありません。まずは目的に対して説明可能な基準構成を置くと、後の比較がしやすくなります。
| 目的 | 基準構成の考え方 | 最初に測るもの |
|---|---|---|
| 学習の仕組みを理解する | 小さなPre-Norm、MHA、GELUまたはSwiGLU、短い固定長 | 損失曲線、勾配ノルム、過学習の有無 |
| 小規模なドメインモデルを試す | 既存実装に近い構成を使い、トークナイザとデータを固定する | 検証損失、目的タスクの品質、学習時間 |
| 長文生成を重視する | 位置表現、学習長、KVキャッシュをまとめて設計する | 長さ別の品質、メモリ、レイテンシ |
| 推論コストを抑える | GQAなどのKVヘッド削減を比較対象にする | トークン毎秒、同時実行数、品質低下 |
ここでいう「基準構成」は、最終製品の設計ではありません。何を変えた結果、何が変わったかを判断するための基準です。実験の初期段階で流行の工夫を一度に入れると、改善しても理由が分からず、悪化しても戻す場所が分からなくなります。
8. 設計を検証するとき、何を記録すべきか?
検証損失だけを見ると、運用で必要な制約を取りこぼします。構成の比較では、性能、安定性、コストを同じ実験記録に残すことが重要です。
| 観点 | 記録する例 | 読み取り方 |
|---|---|---|
| 品質 | 学習・検証損失、目的タスクの指標 | 損失の差が実用上の品質差につながるかを見る |
| 安定性 | 発散回数、勾配ノルム、NaN/Inf、再現性 | 最高値だけでなく、安定して学習できるかを見る |
| 学習コスト | 学習トークン毎秒、GPUメモリ、総学習時間 | 同じ予算でどこまで学習できるかを見る |
| 推論コスト | 初回応答時間、生成速度、KVキャッシュ量 | 想定する入力長と同時実行数で測る |
たとえばGQAを導入して推論メモリが減っても、品質の低下が用途で許容できなければ採用判断は変わります。逆に、ベンチマーク上の差が小さくても、同じGPUで同時実行数を増やせるなら、サービス設計では大きな価値になる場合があります。良い構成は、単一のスコアではなく、目的に対する総合的な適合で決まります。
9. よくある失敗と、設計を戻すための手順
9.1 変更をまとめて入れてしまう
Pre-Norm、RMSNorm、RoPE、SwiGLU、GQAを一度に導入すると、結果が改善してもどの変更が効いたのか分かりません。まず基準構成を固定し、一回の実験では一つの仮説だけを検証します。変更内容、乱数シード、データの版、学習トークン数を記録すれば、後から比較を再現しやすくなります。
9.2 パラメータ数だけをそろえて比較する
パラメータ数が同じでも、学習に使ったトークン数、計算時間、系列長、バッチサイズが違えば、比較は単純ではありません。少なくとも何を固定し、何を変えたかを表にしておきましょう。「同じパラメータ数での比較」と「同じ計算予算での比較」は、異なる問いに答えます。
9.3 長文対応を最大長だけで判断する
設定上の最大長まで入力できることと、遠い位置の情報を正しく使えることは別です。入力の先頭・中央・末尾に必要情報を置いた評価や、長さ別のレイテンシ測定を行い、要求する利用場面に照らして確認します。
9.4 学習が不安定な原因を一つに決めつける
Lossが発散したとき、正規化方式だけを原因と決めるのは早計です。学習率を下げる、ウォームアップを延ばす、勾配ノルムを確認する、混合精度の設定を見直す、データの異常値を調べる、といった順で切り分けます。構成変更は有力な選択肢ですが、診断なしの差し替えは再現性を下げます。
10. まとめ:部品の選択を、設計判断へ変える
今回の要点を整理します。
- Transformerブロックは、Attention、FFN、正規化、残差接続、位置表現を組み合わせた設計単位である
- 新規のDecoder-only LLMでは、Pre-Normを再現性の高い出発点にしやすい
- Attentionのヘッド構成は、学習時の表現だけでなく推論時のKVキャッシュにも影響する
- FFNの中間次元と活性化関数は、性能とパラメータ・計算予算のトレードオフとして比較する
- コンテキスト長は、位置表現の問題と、Attention・KVキャッシュの資源問題を分けて評価する
- 良い構成は流行の部品を多く入れた構成ではなく、目的・制約・検証方法を説明できる構成である
Transformerの設計では、「どの方式が最強か?」という問いに一つの答えはありません。小規模な学習実験、長文の推論サービス、既存モデルの継続学習では、必要な性能、計算資源、変更できる範囲が異なるからです。大切なのは、基準構成を置き、仮説を一つずつ検証し、結果を次の設計へつなげることです。
11. 今回のブログの考察:A-7への橋渡し
A-1からA-6までで、Transformerを構成する部品と、それらを組み合わせる設計判断を見てきました。Embeddingとトークン化は入力の粒度を決め、Attentionと位置表現は文脈の扱いを決め、FFN・正規化・残差接続は表現力と学習のしやすさを支えます。A-6で重要なのは、これらを個別の知識として終わらせず、一つのモデルの制約として結び付けることでした。
次回A-7では、ここまでの理論を総括し、実装・学習・評価の段階へ進むための見取り図を作ります。モデル構成を選んだ後、どの順で実装し、どの指標で確かめ、どこから最適化を始めればよいのか。部品を理解する段階から、検証可能なLLM開発へ進みましょう。
参考文献
- Vaswani, A., Shazeer, N., Parmar, N., et al. (2017). “Attention Is All You Need.” NeurIPS 2017. https://arxiv.org/abs/1706.03762
- Xiong, R., Yang, Y., He, D., et al. (2020). “On Layer Normalization in the Transformer Architecture.” ICML 2020. https://arxiv.org/abs/2002.04745
- Shazeer, N. (2020). “GLU Variants Improve Transformer.” https://arxiv.org/abs/2002.05202
- Zhang, B., & Sennrich, R. (2019). “Root Mean Square Layer Normalization.” NeurIPS 2019. https://arxiv.org/abs/1910.07467
- Ainslie, J., Lee-Thorp, J., de Jong, M., et al. (2023). “GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints.” https://arxiv.org/abs/2305.13245
- Touvron, H., Martin, L., Stone, K., et al. (2023). “Llama 2: Open Foundation and Fine-Tuned Chat Models.” https://arxiv.org/abs/2307.09288
このシリーズの案内
ブログA「Transformer構成」(全7回)では、現代のLLMを支えるTransformerの構成要素を、全体像から実装への接続まで段階的に扱います。
| # | テーマ | 内容 |
|---|---|---|
| A-1 | Transformer構成の基本概念と重要性 | 全体像、部品の役割、データフロー |
| A-2 | Self-Attentionの詳細 | Q・K・V、Causal Mask、マルチヘッド、計算量 |
| A-3 | 正規化と活性化関数 | LayerNorm、RMSNorm、GELU、SwiGLU |
| A-4 | トークン化と語彙構築 | BPE、SentencePiece、語彙サイズの設計 |
| A-5 | 位置エンコーディングの進化 | 絶対位置、相対位置、RoPE、ALiBi |
| A-6 | 構成要素の統合と設計 | Pre-Norm、層構成、推論効率、検証設計(今回) |
| A-7 | 理論の総まとめ | 概念の統合と実装編への橋渡し |
前の記事
次に読む
実装を深掘りしたい方へ
- B-2:バッチ処理と位置エンコーディングの実装
- B-5:FlashAttention実装と速度検証
コメント