A-7:理論を実装へつなぐ
A-6では、Attention、FFN、正規化、位置表現を一つのTransformerブロックとして組み合わせ、性能・計算資源・学習の安定性の間で設計を選ぶ考え方を見ました。ただし、構成を選べても、それだけでモデル開発が進むわけではありません。選んだ構成をどの順番で実装し、何を基準に正しさを確かめ、どの結果を次の改善へつなげるのかまで決めて、初めて設計は実行可能になります。
シリーズ最終回となるA-7では、A-1からA-6の知識を一つの開発の流れとして統合します。目的は「LLaMA風の構成を再現する」ことではありません。自分の目的と制約に対して基準構成を置き、仮説を一つずつ検証できる状態を作ることです。
次回から始まるブログBでは、この見取り図をPyTorchのコードへ落とし込みます。その前に、理論編で学んだ部品が実装・学習・評価のどこで役立つのかを整理しておきましょう。
1. A-1からA-6で、何を理解してきたのか?
このシリーズで扱ってきたのは、Transformerを構成する部品の名称ではなく、各部品が解く問題と、設計上の影響です。全体を振り返ると、モデル開発で確認すべき問いが六つに整理できます。
| 回 | 扱った部品・テーマ | 設計時に答える問い |
|---|---|---|
| A-1 | Transformerの全体像 | どの部品が、どの順番で情報を処理するのか? |
| A-2 | Self-Attention | どのトークン間の関係を、どの計算コストで扱うのか? |
| A-3 | 正規化と活性化関数 | 深い層をどのように安定して学習させるのか? |
| A-4 | トークン化と語彙 | 入力テキストをどの粒度でモデルへ渡すのか? |
| A-5 | 位置エンコーディング | 語順と距離をAttentionへどう伝えるのか? |
| A-6 | 構成要素の統合と設計 | 性能・安定性・コストの制約に対して、どう組み合わせるのか? |
たとえば「長文を扱いたい」という要求は、A-5だけの問題ではありません。位置表現の一般化に加え、A-2で見たAttentionの計算量、A-6で扱ったKVキャッシュと推論メモリ、学習時にどの長さのデータを使うかという問題にも関わります。
このように、一つの要求を複数の部品にまたがって考えられることが、理論を実装へつなぐ第一歩です。
2. Transformerの設計は、どこから始めるのか?
設計の出発点は、モデル名やパラメータ数ではなく、解きたい問題と使える制約です。ここが曖昧なまま構成を選ぶと、「なぜこのヘッド数なのか?」「なぜこのコンテキスト長なのか?」を説明できず、改善の優先順位も決まりません。
最初に、次の四つを文章で書き出します。
- モデルに何をさせたいか
- どの言語・ドメイン・入出力長を扱うか
- 学習と推論に使えるGPUメモリ、時間、予算はどの程度か
- 品質、応答速度、同時実行数のうち、どれを優先するか
たとえば、社内文書の短い要約を試作するなら、最初から非常に長いコンテキストや複雑な推論最適化を入れる必然性は高くありません。一方、長い契約書を横断して回答する用途なら、トークナイザ、位置表現、入力長別の評価、KVキャッシュをまとめて設計対象にする必要があります。
「大きいモデルほど良い」という発想ではなく、「必要な品質を、許容できるコストで達成できるか」を問いの中心に置きます。
3. 基準構成はなぜ必要なのか?
新しい工夫を試したくなる場面ほど、比較の基準となる構成が重要です。基準構成とは、最終的に採用するモデルではなく、変更の効果を測るための出発点です。
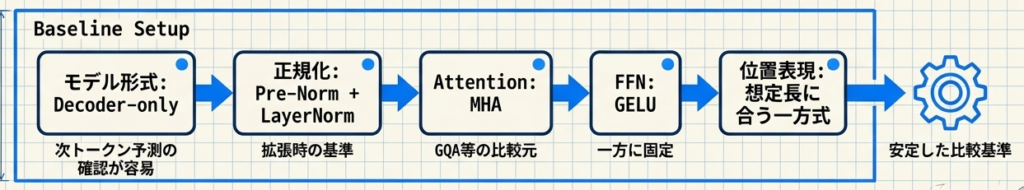
学習の仕組みを理解する小規模な実験なら、次のような素直な構成から始めるとよいでしょう。
| 要素 | 基準として置きやすい選択 | その理由 |
|---|---|---|
| モデル形式 | Decoder-only Transformer | 次トークン予測として学習・生成を確認しやすい |
| 正規化 | Pre-Norm + LayerNormまたはRMSNorm | 深い構成へ拡張するときの基準にしやすい |
| Attention | MHA | GQAやMQAの品質・メモリ差を比較する元にできる |
| FFN | GELUまたはSwiGLU | まずは一方に固定し、比較するときだけ変更する |
| 位置表現 | 想定長に合う一方式 | 位置表現とコンテキスト長の検証を切り分けやすい |
よくある失敗は、RoPE、RMSNorm、SwiGLU、GQA、長文スケーリングを同時に入れてしまうことです。学習結果が良くても、どの変更が寄与したのか分かりません。悪くなった場合も、戻すべき箇所を特定できません。
まず基準構成を一度最後まで動かし、その後に「GELUをSwiGLUへ変える」「MHAをGQAへ変える」のように、検証する仮説を一つへ絞ります。
基準構成は最終モデルではない。変更の効果を測るための出発点。変える要素は「1回の実験につき1つ」に絞る。
4. 設計書には何を残すべきなのか?
設定値をコードの中だけに置くと、数週間後には「この値をなぜ選んだのか?」が分からなくなりがちです。小さな実験でも、構成と判断理由を一枚の設計メモに残すだけで、比較の質が上がります。
| 項目 | 記録する内容の例 |
|---|---|
| 目的 | 短文要約の品質を確認する、長文検索の前段を評価する |
| データ | データの版、件数、言語、重複除去・分割の方針 |
| トークナイザ | 方式、語彙サイズ、未知語や日本語の分割例 |
| 構成 | 層数、隠れ次元、ヘッド数、FFN中間次元、位置表現 |
| 学習条件 | 学習トークン数、バッチサイズ、学習率、ウォームアップ、乱数シード |
| 評価 | 検証損失、目的タスク、長さ別の品質、推論速度 |
| 仮説 | 何を変え、どの指標がどう変わると予想するか |
設計メモは、立派な文書である必要はありません。ただし「変更前後で何が違うか」が読める必要はあります。特にデータの版と乱数シードを残さないと、構成の変更による差とデータの違いによる差を後から区別しにくくなります。
実装では、設定を一か所へ集めておくと、比較条件を保ちやすくなります。以下は、B-1でTransformerブロックを作る際に使える最小の設定例です。数値は学習用の小規模な例であり、用途に応じて検証しながら変更します。
from dataclasses import dataclass

@dataclass
class TransformerConfig:
    vocab_size: int = 32_000
    d_model: int = 256
    n_layers: int = 6
    n_heads: int = 4
    d_ff: int = 1_024
    max_seq_len: int = 512
    norm_type: str = "layernorm"
    activation: str = "gelu"
    position_encoding: str = "rope"

config = TransformerConfig()
assert config.d_model % config.n_heads == 0設定値を変えるときは、コード内の数値だけを書き換えるのではなく、設計メモの仮説と実験記録も同時に更新します。これにより、たとえばn_layersを増やした結果と、意図せず変わった学習条件を混同しにくくなります。
5. 実装では、どの順番で正しさを確かめるのか?
Transformerを最初から大きく学習させる必要はありません。むしろ、部品ごとに小さく確認してから統合するほうが、問題を見つけやすくなります。
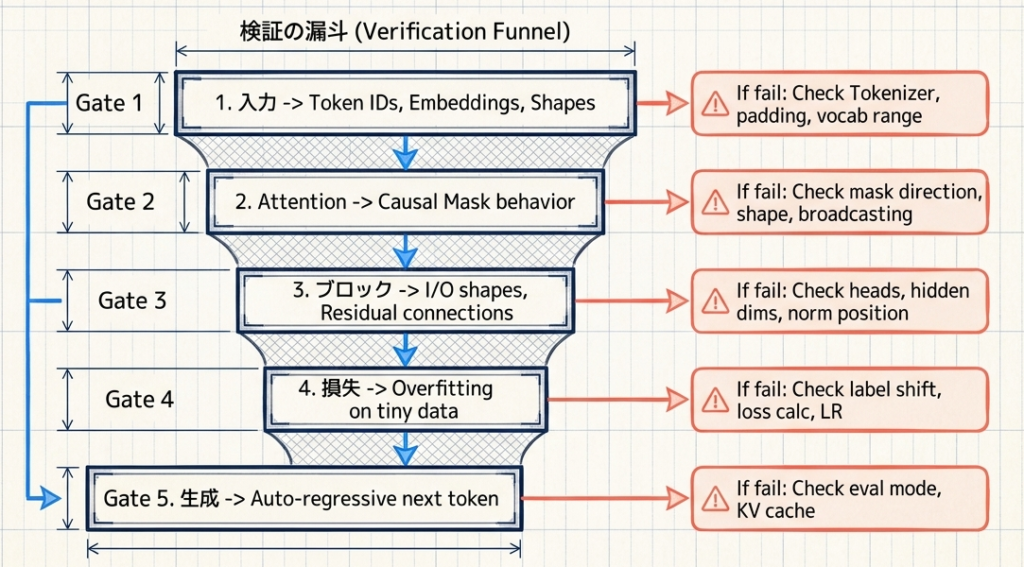
| 段階 | 最初に確認すること | 問題が起きたときに疑う場所 |
|---|---|---|
| 入力 | トークンID、Embedding、形状が想定どおりか | トークナイザ、padding、語彙範囲 |
| Attention | Causal Maskが未来のトークンを参照しないか | マスクの向き、shape、ブロードキャスト |
| ブロック | 入出力形状と残差接続が保たれるか | ヘッド数、隠れ次元、正規化の位置 |
| 損失 | ごく少量のデータを意図的に過学習できるか | ラベルのずれ、損失計算、学習率 |
| 生成 | 学習済み重みで次トークンを順に生成できるか | Causal Mask、evalモード、KVキャッシュ |
特に有効なのは、小さな固定データセットに対してLossを十分に下げられるかを見る確認です。これは汎化性能を測る実験ではありません。実装・ラベル・最適化のどこかに大きな不整合がないかを早い段階で見つけるためのテストです。
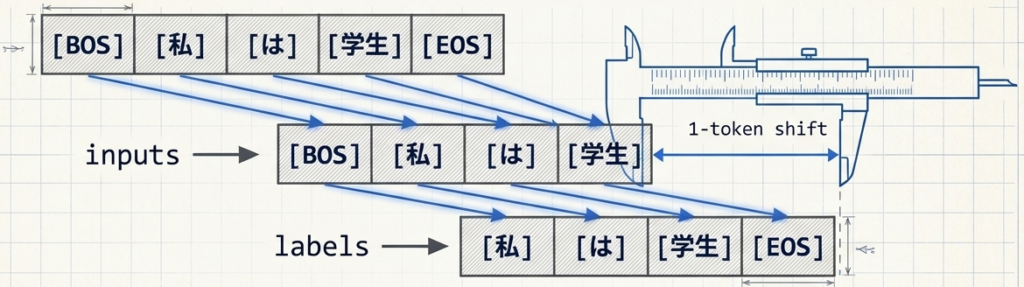
次トークン予測では、入力と正解ラベルを一つずらします。以下の最小例では、modelが(batch, sequence, vocab_size)のlogitsを返すことを前提に、損失を計算しています。
import torch
import torch.nn.functional as F

def next_token_loss(
    model,
    input_ids: torch.Tensor,
    pad_token_id: int | None = None,
) -> torch.Tensor:
    # 例: [BOS, 私, は, 学生, EOS] から
    #     [私, は, 学生, EOS] を予測する
    inputs = input_ids[:, :-1]
    labels = input_ids[:, 1:].clone()
    if pad_token_id is not None:
        labels[labels == pad_token_id] = -100

    logits = model(inputs)  # (batch, sequence - 1, vocab_size)
    return F.cross_entropy(
        logits.reshape(-1, logits.size(-1)),
        labels.reshape(-1),
        ignore_index=-100,
    )
この確認でLossが下がらない場合は、モデルの規模を増やす前に、ラベルのシフト、paddingの除外、Causal Mask、model.train()とmodel.eval()の切り替えを確認します。
ここでLossがまったく下がらない場合、モデルを大きくしたり学習を長くしたりしても、原因は隠れたままです。まず小さく再現できる状態に戻ることが、結果的に最短の道になります。
汎化性能のテストではない。実装・ラベル・最適化の致命的な不整合(padding除外漏れ、Causal Maskのミス等)をあぶり出すための構造チェック。
6. 学習曲線から、何を読み取るのか?
学習を開始したら、最終Lossだけでなく、変化の過程を見ます。学習曲線は、構成・データ・最適化の問題を切り分けるための重要な手掛かりです。
| 観測された傾向 | 考えられる要因 | まず確認すること |
|---|---|---|
| 学習Lossも検証Lossも下がらない | 学習率、実装、データ、モデル容量 | 少量データの過学習、ラベルのずれ、学習率 |
| 学習Lossだけ下がる | 過学習、学習・検証データの分布差 | データ分割、重複、正則化、評価データ |
| 突然NaNやInfになる | 数値不安定、学習率過大、入力異常 | 勾配ノルム、混合精度、入力値、正規化 |
| 改善が早期に止まる | 学習トークン不足、最適化、データ品質 | 学習率スケジュール、データの多様性、比較条件 |
一つの曲線から原因を断定することはできません。たとえば検証Lossの悪化は過学習の可能性を示しますが、評価データの偏りや、学習・検証で前処理が違うことでも起こり得ます。曲線は結論ではなく、次に確認すべき仮説を絞るための証拠として扱います。
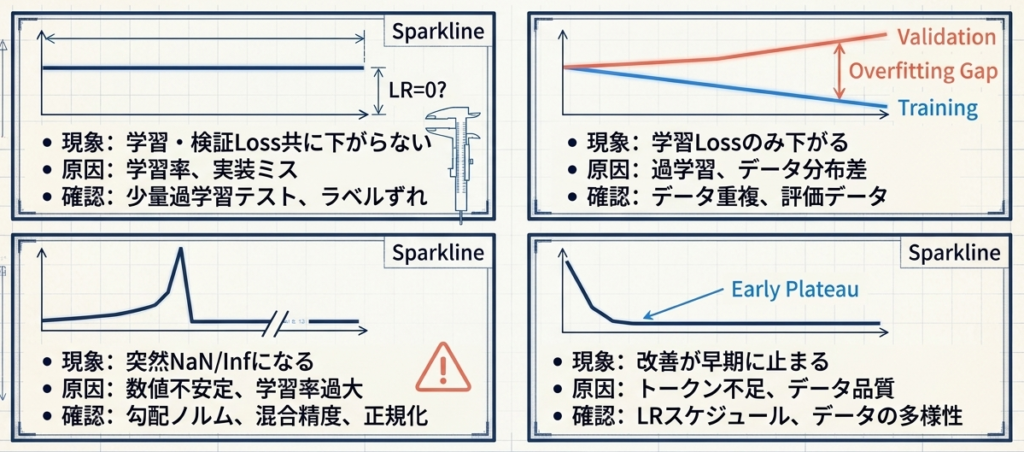
一つの曲線から原因を断定することはできない。次に確認すべき仮説を絞るための手掛かりとして扱う。
7. 性能とコストは、どのように一緒に評価するのか?
A-6で見た通り、良い構成は単一のベンチマークスコアだけでは決まりません。学習と推論で実際に使えるかまで含めて評価します。
| 観点 | 代表的な指標 | 見落としやすい点 |
|---|---|---|
| モデル品質 | 検証Loss、目的タスクの正確さ、生成例 | Lossが用途に必要な品質を直接表すとは限らない |
| 学習効率 | 学習トークン毎秒、GPUメモリ、収束までの時間 | 速くても同じ品質に届かなければ比較にならない |
| 推論効率 | 初回応答時間、生成速度、同時実行数 | 入力長やKVキャッシュで結果が大きく変わる |
| 安定性 | 発散回数、再実行時のばらつき、NaN/Inf | 最良の一回だけを見ると不安定さを見落とす |
たとえばGQAはKVキャッシュを減らし、推論時のメモリ制約を緩和できる場合があります。しかし、同じデータ・同じ学習条件で品質を測らなければ、その差がヘッド構成によるものか判断できません。構成を比べるときは、何を固定し、何を変えるかを先に決めます。
8. スケーリング則は、どのように使うのか?
パラメータ数や訓練トークン数を増やすと、損失が経験的に改善する傾向は多くの研究で報告されています。ただし、スケーリング則は「次に大きくすれば必ず成功する」という保証ではありません。観測されたデータ、モデル構成、最適化方法、計算予算の範囲に依存する経験則です。
小規模な開発でスケーリング則を役立てるなら、外部の係数をそのまま当てはめるより、次のように使うのが安全です。
- まず小さな複数規模のモデルを同じ評価条件で学習する
- パラメータ数、訓練トークン数、検証Loss、学習時間を記録する
- どの要素が先に制約になっているかを確認する
- 次の実験で増やすものを、モデル・データ・系列長のいずれか一つに決める
データが少ないのにモデルだけを大きくしても、期待した改善が出ない場合があります。逆に、モデルを大きくする前に重複や品質の低いデータを見直したほうが、改善につながる場合もあります。スケーリング則は予言の道具ではなく、限られた実験予算をどこへ配分するか考える補助線です。
9. よくある失敗を、次の実験にどう生かすのか?
9.1 公開モデルの設定をそのままコピーする
公開モデルの構成は有益な出発点ですが、訓練データ、GPU構成、最適化、学習トークン数まで同じとは限りません。特定の層数や学習率だけを切り取ると、前提が失われます。参考にするときは、構成値だけでなく、何の制約に対応するための設計だったのかを確認します。
9.2 実装の正しさを、長時間の学習で確かめようとする
数時間学習してから「Lossが下がらない」と気付くのは、もっとも避けたい失敗の一つです。テンソル形状、Causal Mask、ラベルのシフト、少量データでの過学習を先に確認すれば、原因を狭い範囲で探せます。
9.3 数字だけで、生成品質を判断する
検証Lossは重要ですが、要約、コード補完、対話などの実際の用途に必要な性質をすべて表すわけではありません。定量評価とともに、用途に即した固定プロンプトで生成例を比べ、失敗例も残します。主観的な印象だけで結論を出さず、評価基準を先に決めることが大切です。
9.4 改善しなかった実験を記録しない
期待どおりの結果にならなかった実験にも価値があります。何を固定し、何を変え、どの指標がどうなったかを残せば、同じ遠回りを避けられます。失敗を「モデルが弱かった」で終わらせず、データ、実装、最適化、評価のどこまで確認できたかを記録しましょう。
10. 実装編へ進む前のチェックリスト
理論編を終えた時点で、すべての設計値を決め切る必要はありません。B-1へ進む前に、少なくとも次の問いへ答えられれば十分です。
- 作りたいモデルの用途と、最初に評価するタスクは何か
- トークナイザと想定最大系列長をどのように選んだか
- 最初の基準構成で、何を固定し、何を後で比較するか
- 学習が正しいと判断するために、どの小さなテストを行うか
- 品質・学習コスト・推論コストのどの指標を記録するか
この五つに答えられれば、実装中に選択を迫られても、流行や印象だけで決めずに済みます。B-1では、この設計を最小のTransformerブロックへ落とし込み、テンソルの形状、Causal Mask、残差接続、正規化をコードで確認します。
11. まとめ:理解した部品を、検証できる開発へ変える
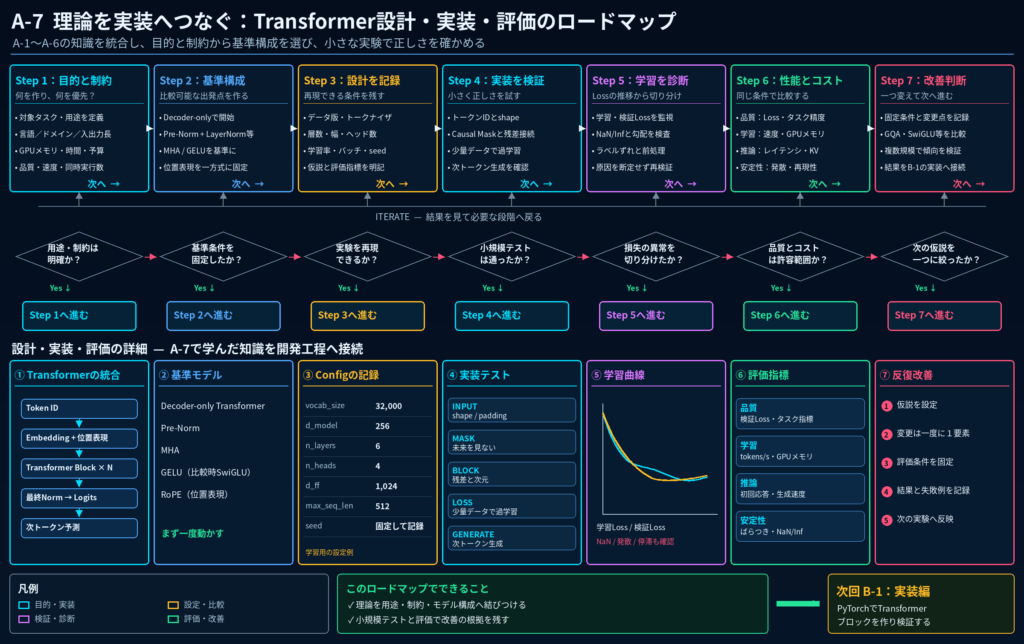
今回の要点を整理します。
- Transformerの構成要素は、互いに独立した機能ではなく、目的と制約の中で影響し合う設計である
- 設計はモデル名やパラメータ数ではなく、用途、データ、コンテキスト長、計算資源から始める
- 基準構成を用意し、一回の実験で変える要素を一つに絞ると、結果を解釈しやすい
- 実装は、形状、マスク、少量データでの過学習、生成という小さな確認を積み重ねる
- 評価では品質だけでなく、学習・推論コストと安定性を同じ記録に残す
- スケーリング則は万能の予測式ではなく、限られた実験予算を配分するための補助線として使う
Transformerを理解するとは、AttentionやRoPEの説明を暗記することではありません。目的に対して必要な部品を選び、制約を明らかにし、結果から次の設計を判断できることです。ここまでの理論は、実装で一度動かし、観測し、修正して初めて自分の知識になります。
12. 今回のブログの考察:B-1への橋渡し
A-1からA-7までで、Transformerを「部品の集合」ではなく、「設計・学習・評価を繰り返す対象」として捉えるための土台を作りました。重要なのは、最初から大規模なLLMを再現することではありません。小さなモデルでも、入力から損失、生成までの流れを理解し、観測した結果を基に一つずつ改善できることです。
次回B-1では、ここまでの理論をPyTorchで実装します。まずは最小のTransformerブロックを作り、Self-Attention、FFN、残差接続、正規化が、テンソルの形状と計算の中でどのようにつながるかを確認します。理論上の設計を、実際に動くモデルへ変えていきましょう。
参考文献
- Vaswani, A., Shazeer, N., Parmar, N., et al. (2017). “Attention Is All You Need.” NeurIPS 2017. https://arxiv.org/abs/1706.03762
- Kaplan, J., McCandlish, S., Henighan, T., et al. (2020). “Scaling Laws for Neural Language Models.” https://arxiv.org/abs/2001.08361
- Hoffmann, J., Borgeaud, S., Mensch, A., et al. (2022). “Training Compute-Optimal Large Language Models.” NeurIPS 2022. https://arxiv.org/abs/2203.15556
- Touvron, H., Martin, L., Stone, K., et al. (2023). “Llama 2: Open Foundation and Fine-Tuned Chat Models.” https://arxiv.org/abs/2307.09288
- Ainslie, J., Lee-Thorp, J., de Jong, M., et al. (2023). “GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints.” https://arxiv.org/abs/2305.13245
このシリーズの案内
ブログA「Transformer構成」(全7回)では、現代のLLMを支えるTransformerの構成要素を、全体像から実装への接続まで段階的に扱いました。
| # | テーマ | 内容 |
|---|---|---|
| A-1 | Transformer構成の基本概念と重要性 | 全体像、部品の役割、データフロー |
| A-2 | Self-Attentionの詳細 | Q・K・V、Causal Mask、マルチヘッド、計算量 |
| A-3 | 正規化と活性化関数 | LayerNorm、RMSNorm、GELU、SwiGLU |
| A-4 | トークン化と語彙構築 | BPE、SentencePiece、語彙サイズの設計 |
| A-5 | 位置エンコーディングの進化 | 絶対位置、相対位置、RoPE、ALiBi |
| A-6 | 構成要素の統合と設計 | Pre-Norm、層構成、推論効率、検証設計 |
| A-7 | 理論を実装へつなぐ | 設計・実装・評価の見取り図(今回) |
前の記事
次に読む
この先の実装編
- B-2:バッチ処理と位置エンコーディングの実装
- B-3:自動微分とバックプロパゲーション最適化
- B-4:混合精度演算
コメント